夜勤中にアラートが鳴り、画面の前で固まってしまったことはありませんか。「自分が動いていいのか、先輩を待つべきか」がわからない人は多いはずです。
この記事では、インシデントが起きた瞬間に新人がやるべきことと、そのやり方がわかります。結論から言うと、新人の仕事は直すことではなく「止めない・消さない・知らせる」です。
インシデント対応とは?新人が読みたい2つの記事
インシデントとは、システム障害や情報漏えいなど、業務に悪い影響が出る出来事のことです。2026年9月には、このテーマの記事が2本、QiitaとZennに公開されました。
1本目はQiitaに投稿された書評です。日本シーサート協議会のセキュリティ人材育成のワーキンググループが編んだ『改訂新版 セキュリティエンジニアの教科書』を紹介しています。
書評の投稿者は、指示待ちで動けずにいると初動が遅れて被害が広がると書いています。まず仕事全体の地図を頭に入れ、自分がどこを担当しているのかを確かめることを勧めていました。
2本目はZennの記事で、エンジニア歴11年目の投稿者が本番のデータベースを消してしまった体験談です。ベテランでも事故は起きることを、原因と再発防止策まで含めて率直に書いています。
本番DB削除インシデントの実例:11年目でも起きた
この事例から学べるのは、事故の原因は腕前ではなく「しくみ」にあるということです。流れを順に見てみましょう。
- 連休前に本番へマイグレーションした際、手元の設定ファイル(.env)に本番DBの接続先を書いたまま連休(シルバーウィーク)に入った
- 連休明け、ローカルのDBを初期化するつもりで「prisma migrate reset」を実行した
- 続けて初期データ(シード)を流したのに入っていないように見え、調べると消したのが本番だったと判明した
- クラウドDB(Neon)のBackup & Restore機能で1日前まで戻せる状態だったため復旧でき、止まっていた時間は約1時間だった
消えた顧客データは1件で、アクセスログを見る限り影響はほぼゼロだったそうです。ただし投稿者自身、サービスが育った後なら終わっていたと振り返っています。
再発防止策として、ローカル以外の接続先ではスクリプトを止めるガードを入れ、本番の接続先を手元の.envに置かないことにしています。ほかに、バックアップで戻せる期間の確認、長い休みの前に作業状態を記録しておくこと、AIエージェントに破壊的なDB操作を禁じるルールも挙げていました。
設定ファイルに本番の鍵を置く危うさは、APIキーを.envに置くのが危ない理由の記事でもくわしく解説しています。
CSIRTとは?インシデント対応の全体の地図
CSIRT(シーサート)とは、セキュリティ事故に対応する社内の専門チームのことです。新人がまず知るべきなのは、このチームが動く全体の流れです。
インシデント対応の流れとしては、米国NISTのガイド(SP 800-61)の第2版で示された次の4段階がよく知られています(2025年に第3版へ改訂)。
- 準備:手順書や連絡先、バックアップを事前にそろえる
- 検知と分析:アラートやログから、何が起きたかを見きわめる
- 封じ込め・復旧:被害の広がりを止め、元の状態に戻す
- 事後対応:原因を振り返り、再発防止策を決める
全体をまとめる役は、書評では「全体統括(CSIRTコマンダー)」として紹介されています。消防にたとえるなら現場指揮官で、誰が何をするかを決める役です。
新人が主に関わるのは、2番目の「検知と分析」の入り口です。つまり最初に気づく人として、正しく情報を渡す役目を担っています。
インシデント初動で新人がやる5つのこと
新人の初動は、次の5つにしぼれば十分です。どれも技術力より「落ち着き」で差がつくものだからです。
- 時刻を書き留める:気づいた時刻、見た画面、自分がした操作をメモする
- すぐに報告する:「原因はまだ不明です」でよいので、まず先輩やリーダーへ伝える
- 勝手に直さない:再起動やリセットは、指示が出るまで待つ
- ログや画面を消さない:証拠が消えると、原因がたどれなくなる
- 接続先を声に出して確かめる:本番か検証環境かを確認してからコマンドを打つ
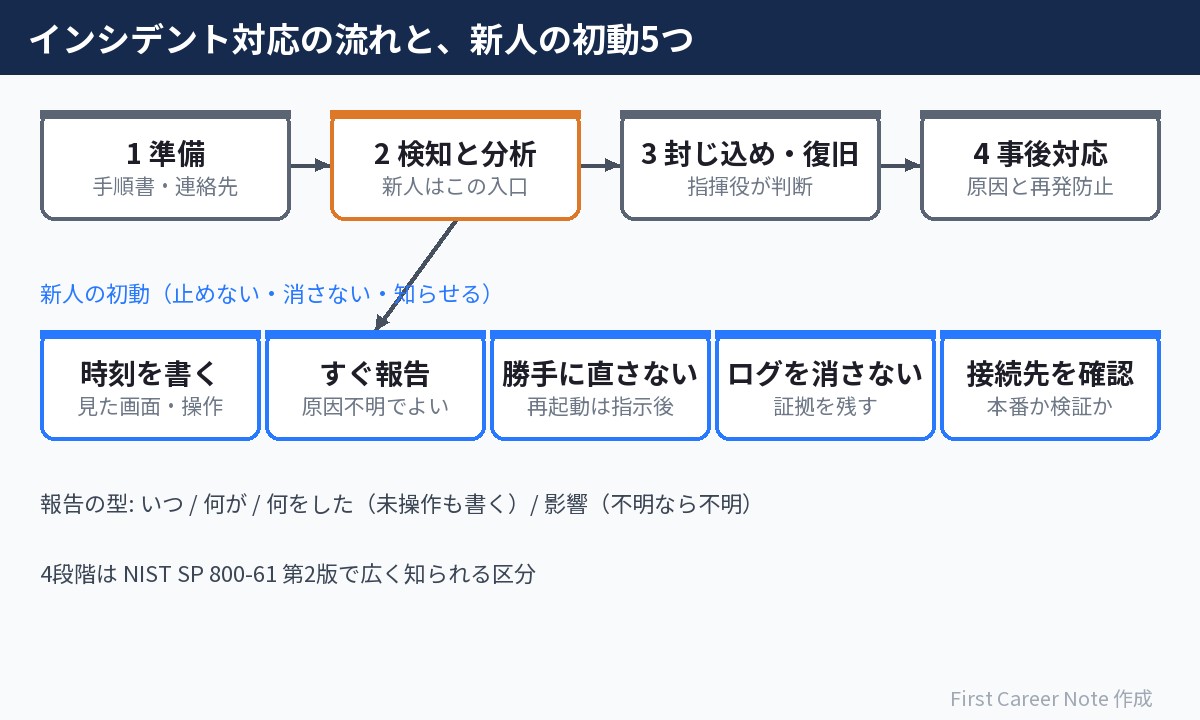
とくに3と4は、良かれと思ってやりがちな失敗です。再起動で直っても、なぜ落ちたのかがわからなくなります。
5は、まさに今回の事例で抜けていた確認です。焦っている時ほど、ベテランでも接続先を取りちがえます。
どのログを見ればよいかは、アクセスログで侵害の兆候を見つける記事が参考になります。
筆者の考察:インシデント初動は「報告の型」で決まる
筆者は、新人が最初に身につけるべきなのは、技術よりも「報告の型」だと考えます。初動の遅れの多くは、何をどう伝えればいいか迷う時間から生まれるからです。
おすすめは、次の4行をメモ帳に用意しておくことです。
- いつ:気づいた時刻
- 何が:見えている症状(例 監視画面でWebサーバーの応答なし)
- 何をした:自分が行った操作。何もしていなければ「未操作」
- 影響:わかる範囲で。不明なら「不明」
この型があれば、原因がわからなくてもすぐに報告できます。夜勤のひとり当番でも、埋めて送るだけで動けます。
最近はAIに一次調査を任せる動きもあります。ただ、その結果を人に届ける報告の型は変わりません。深夜アラートの一次調査をAIに任せる記事もあわせて読んでみてください。
障害対応のあとで「誰が何を打ったか」を追えるようにする手順書の工夫は、実行できる手順書LC4RIの考え方で紹介しています。
漏えい事案の発表でよく見る「パスワードは復元できない形式で保管」の意味は、漏れても「復元できない」パスワード|ハッシュ化とソルトの仕組みで解説しています。
アラートが鳴らないまま失敗しているバッチに気づくための監視の観点は、バッチ監視は「動いた」では足りない|起動・生存・終了・復旧の4観点で整理しています。
変更作業のあとに古い版へ戻っていた事例と、作業後の確認項目は、Terraformで本番が旧版に|ignore_changesの罠で整理しています。
被害が起きる前の備えとして、バックアップの置き場所と復元の訓練についてはランサムウェアはバックアップも狙う|オフライン保管と復元訓練で整理しています。
クラウドの基盤ごと止まったとき、データをどこから戻すかを事前に言えるようにしておくと初動が早くなります。クラウドのデータは誰が守る?|IDCF障害で見る責任共有モデルもあわせて読んでみてください。
まとめ:インシデント初動は止めない・消さない・知らせる
- 11年目のエンジニアでも本番DBを消すことがあり、原因は腕前より「しくみ」にある
- インシデント対応には準備・検知・復旧・事後の流れがあり、新人は最初に気づく役を担う
- 初動は、時刻のメモ・即報告・勝手に直さない・ログを消さない・接続先確認の5つで十分
まずは、いつ・何が・何をした・影響の4行の報告テンプレートを、今日のうちにメモ帳へ作っておきましょう。
参考リンク
- インシデントが起きた瞬間、自分が何をすべきか分からない人へ。CSIRTの動き方まで見渡せる教科書(Qiita) ― 『改訂新版 セキュリティエンジニアの教科書』の書評
- 11年生本番データ飛ばす(Zenn) ― 本番DB削除の経緯・復旧・再発防止策
- SP 800-61 Rev. 2, Computer Security Incident Handling Guide(NIST) ― インシデント対応の4段階(2025年に第3版へ改訂)

コメント
コメント一覧 (7件)
[…] 障害時に何を記録すべきかは、インシデント初動で新人がやる5つのことの記事で整理しています。 […]
[…] この説明ができるだけで、エスカレーション(上位者への報告)の質が上がります。初動の流れはインシデント初動で新人がやる5つのことの記事もあわせて読んでみてください。 […]
[…] また、異常に気づいたあとの動き方はインシデント初動で新人がやる5つのこと、確認結果の残し方は実行できる手順書LC4RIの記事が参考になります。 […]
[…] 兆候に気づいたあと、最初の数分で何をするかはインシデント初動で新人がやる5つのことを参考にしてください。 […]
[…] 被害に気づいた直後の動き方は、インシデント初動で新人がやる5つのことでまとめています。バックアップのジョブが本当に終わっているかを見張る方法は、バッチ監視の4つの観点が参考になります。侵入の兆しの見つけ方は、アクセスログから侵害の兆候を見つける記事も読んでみてください。 […]
[…] もしあやしい山を見つけたら、自分で消したり止めたりせず、まず報告することが大切です。初動の動き方は、インシデント初動で新人がやる5つのことを参考にしてください。データを守る最後の砦としては、ランサムウェアはバックアップも狙う|オフライン保管と復元訓練もあわせて読んでおくと安心です。 […]
[…] アクセスログで侵害の兆しを探す集計のしかたは、アクセスログの404より怖い200で詳しくまとめています。気づいたあとの動き方は、インシデント初動で新人がやる5つのこともあわせて読んでみてください。 […]