夜勤中、バッチのアラートが1件も鳴らずにホッとした朝はありませんか。でも「鳴らなかった」ことは、本当に「正常に終わった」ことを意味するのでしょうか。
この記事では、バッチ監視で確かめるべき4つの観点と、監視そのものが壊れる落とし穴がわかります。結論から言うと、エラーを待つのではなく「来るはずの合図が来ない」ことを検知するのがポイントです。
バッチ監視とは?エラー通知だけでは足りない理由
バッチ監視とは、決まった時刻に動く一括処理が、予定どおり最後まで動いたかを見張ることです。エラー通知だけでは、この目的を果たせません。
理由は、バッチの失敗には「エラーを出さない失敗」が多いからです。そもそも起動しない、途中で固まる、終わらないまま朝になる、といった状態です。
たとえるなら、新聞配達を「配達員から事故の電話が来たら対応」だけで管理しているようなものです。配達員が寝坊して家を出ていなければ、電話は一生かかってきません。
つまりバッチ監視では、エラーの有無ではなく「進み具合の合図」を見る必要があります。
バッチ監視の4つの確認観点とは
この考え方は、2026年9月29日にQiitaに投稿された「バッチ監視で学んだ4つの確認観点」という記事で整理されています。書いたのはソーイ株式会社の方で、同社が受託開発した案件でバッチの監視とテストを担当した経験をまとめたものです。
その案件では、LaravelのSchedulerで定期実行するバッチを、CloudWatch Logsへのログ出力、Laravel Cacheを使ったハートビート、監視用のAPI、外形監視の組み合わせで見張っています。
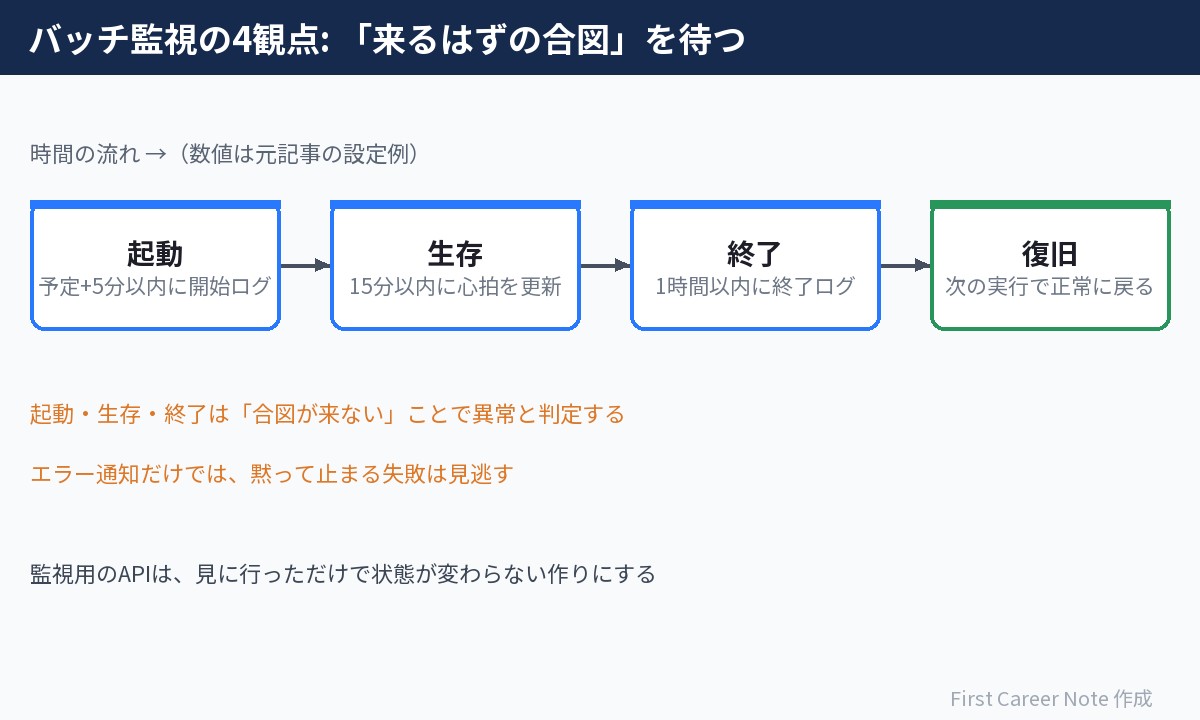
記事では、確認すべき観点を次の4つに整理しています。
- 起動:予定時刻に始まったか
- 生存:処理が止まらず進んでいるか
- 終了:時間内に最後まで終わったか
- 復旧:異常のあと、正常に戻れたか
どれも当たり前に見えますが、1つでも欠けると気づけない失敗が残ります。以下で順に見ていきます。
バッチ監視の観点1・2:起動と生存を確かめる
起動と生存は「始まったか」「動き続けているか」を、合図の有無で判定します。黙って止まる失敗を拾えるのは、この2つだけだからです。
起動:予定時刻+猶予の間に開始ログがあるか
元記事では、バッチの開始時に「action:start」というログを出しています。対象のバッチは毎時00分に動くため、予定時刻から5分の猶予を置き、その間に開始ログがなければ異常と判定しています。
5分の猶予を置くのは、少しの遅れで誤報を出さないためです。
生存:ハートビートが止まっていないか
ハートビート(心拍)とは、処理中に「まだ生きています」と定期的に記録する合図のことです。元記事では、各処理フェーズの開始・終了や、時間のかかる処理の途中で記録を更新しています。
最後の記録から15分以上たっても更新がなければ、処理が固まったと判定します。病院の心電図モニターが、脈が止まると鳴るのと同じ考え方です。
バッチ監視の観点3・4:終了と復旧を確かめる
終了と復旧は「やりきったか」「元に戻れるか」を確かめる観点です。始まっても終わらなければ、次の処理や朝の業務に影響が出るからです。
終了:開始と終了をIDでひもづける
元記事では、実行ごとにIDを付け、開始ログと終了ログを同じIDでひもづけています。開始から1時間たっても、同じIDの「action:end」がなければ異常です。
IDでひもづけるのは、前回の終了ログを今回分と取り違えないためです。
復旧:わざと壊して、戻るまでを試す
元記事では、テストでバッチをわざと途中終了させています。監視用のAPIが異常(500)を返すことを確かめ、次の正常な実行で正常(200)に戻るかまで見ています。
異常を検知できても、正常に戻れなければアラートが鳴りっぱなしになります。そうなると、本当の異常を見逃す原因になります。
図解:バッチ監視の4観点と「気づけない失敗」
筆者なりに、4つの観点と、それが欠けたときに見逃す失敗を表にまとめました。自分の現場の監視と見比べてみてください。
| 観点 | 見る合図 | 欠けると見逃す失敗 |
|---|---|---|
| 起動 | 開始ログ(予定+5分以内) | スケジューラ停止で一度も動いていない |
| 生存 | ハートビート(15分以内に更新) | ロック待ちなどで固まったまま |
| 終了 | 同じIDの終了ログ(1時間以内) | 終わらないまま朝の業務が始まる |
| 復旧 | 次回実行で監視が正常に戻る | アラートが鳴りっぱなしで慣れてしまう |
ポイントは、4つのうち3つが「合図が来ないこと」を検知している点です。エラー通知の設定だけでは、この3つはまるごと抜け落ちます。
筆者の考察:バッチ監視そのものが状態を変える落とし穴
元記事でいちばん学びが大きいと感じたのは、監視の失敗談です。監視を見に行く操作そのものが、監視の結果を変えてしまっていました。
元記事では、外形監視(外部のサービスから定期的にアクセスして応答を確かめる監視)にUptimeRobotを使っていました。確かめると、GETでは500、HEADでは200という食い違いが出たそうです。UptimeRobotのHTTPの監視では、HEADリクエストが使われていました。
原因はHTTPの種類の違いではありませんでした。最初のGETで通知済みの時刻(alerted_at)が記録され、監視用のAPIの状態が変わっていたのです。
運用の現場に置きかえると、「確認のためのコマンドが、実は何かを書き換えていた」という事故と同じです。元記事も、ヘルスチェック用のAPIは参照しただけで状態が変わらない設計にすることが重要だ、とまとめています。
確認作業を読み取り専用にする考え方は、深夜アラートの一次調査をAIに任せる記事でも詳しく扱っています。
また、異常に気づいたあとの動き方はインシデント初動で新人がやる5つのこと、確認結果の残し方は実行できる手順書LC4RIの記事が参考になります。
「applyが成功した」だけでは正しく動いている証明にならない例は、Terraformで本番が旧版に|ignore_changesの罠で取り上げています。
バックアップのジョブが成功していても、ランサムウェアに耐えられるとは限りません。保存先の分け方と復元の訓練はランサムウェアはバックアップも狙う|オフライン保管と復元訓練を参考にしてください。
監視で「ふだんの量」を覚えておくと、エラーの出ない情報漏洩にも気づきやすくなります。普段どおりのアクセスで漏れる情報|発覚まで15日かかった理由もあわせて読んでみてください。
まとめ:バッチ監視は「来ない合図」を見る
- バッチの失敗は、起動しない・固まる・終わらないなど「エラーを出さない失敗」が多い
- 起動・生存・終了・復旧の4観点で、来るはずの合図が来ないことを検知する
- 監視や確認の操作は読み取り専用にし、わざと壊して復旧まで試す
まずは担当しているバッチを1つ選び、4つの観点のどれが監視されているかを確かめてみましょう。
参考リンク
- バッチ監視で学んだ4つの確認観点 ― 起動/生存/終了/復旧を確認しよう(Qiita) ― 元記事(2026-09-29)。4観点の設定例・復旧テスト・GETとHEADの食い違い
- Task Scheduling(Laravel公式ドキュメント) ― Laravelのスケジューラの仕組み
- Amazon CloudWatch Logs とは(AWS公式ドキュメント)
- Introducing HTTP Method Selection(UptimeRobot公式ブログ) ― HTTP監視は既定でHEADリクエストを使うという説明

コメント
コメント一覧 (3件)
[…] 夜間バッチを「起動・生存・終了・復旧」のどこまで見張れているかを確かめる観点は、バッチ監視は「動いた」では足りない|起動・生存・終了・復旧の4観点で解説しています。 […]
[…] これは「動いた」だけで安心しないという、監視の基本と同じ考え方です。くわしくはバッチ監視の4観点の記事でも扱っています。 […]
[…] 被害に気づいた直後の動き方は、インシデント初動で新人がやる5つのことでまとめています。バックアップのジョブが本当に終わっているかを見張る方法は、バッチ監視の4つの観点が参考になります。侵入の兆しの見つけ方は、アクセスログから侵害の兆候を見つける記事も読んでみてください。 […]