「AIを自分の手元で動かしてみたい。でもGPUもメモリも足りない」。そう思って、あきらめたままになっていませんか。
この記事では、モデルを小さくする「量子化」のしくみを、9月に公開された具体例からかみくだいて説明します。量子化・蒸留・プルーニングの違いと、試す前に見るべき数字まで持ち帰れます。
結論から言うと、いま進んでいるのは賢さの進化よりも「置き場所の進化」です。同じくらいの賢さのまま、置ける場所が手元のパソコンまで降りてきました。
3値量子化とは?27Bのモデルが5.9GBに収まった
3値量子化とは、モデルの中身の数値を「-1・0・+1」の3つだけで表して容量を減らす手法です。量子化(りょうしか)は、細かい数値をざっくりした段階に置きかえる圧縮のことを指します。
具体例になったのは、PrismMLが2026年9月17日(米国時間)に公開した「Ternary Bonsai 2 27B」です。Qwen3.8 27Bをベースに3値量子化をかけたマルチモーダルモデルで、270億(27B)という規模はそのままに、1つの重みあたりの実効ビット数を1.76ビット、モデル全体を5.9GBに収めたと発表されています。文脈の長さは262Kトークン、入力はテキストと画像に対応し、重みはApache License 2.0でHugging Faceに公開されました。
ふつう、この規模のモデルは1つの重みを16ビットで持ちます。単純に計算すると50GBを超え、個人のパソコンではまず載りません。公式も「9倍以上小さい」と表現しています。5.9GBなら、メモリ16GBのノートパソコンでも現実味が出てきます。
ここで「3つの値なら1.58ビット(2の1.58乗が3)では?」と気づいた方は鋭いです。差の分は、重みをまとまりごとに何倍するかという倍率(スケール)を、別途FP16で持っているぶんです。3つに丸めるだけでは元の大きさが分からなくなるので、「どのくらいの大きさだったか」をまとまり単位で覚えておく、という作りになっています。
身近なたとえで言えば、写真をRAWからJPEGに変えるのに近い発想です。細かい階調は捨てますが、見た目はそれほど変わりません。捨てても困らない細かさを見きわめるのが、量子化のうまさです。
量子化しても賢さが落ちにくいのはなぜか
結論として、モデルの中身には「そこまで細かくなくても結果が変わらない部分」が多く含まれています。だから粗くしても答えが大きくは崩れません。
Ternary Bonsai 2 27Bの場合、推論・数学・コーディング・指示に従う力・画像認識・ツール呼び出しをまとめた総合スコアが83.9でした。圧縮していないQwen3.8 27Bは85.4なので、98.2%を保った計算になります。速度は公式ニュースリリースで、GeForce RTX 5090で最大143トークン/秒、Apple M5 Maxで46.8トークン/秒と示されています。
ただし「ほぼ同じ」は平均の話です。おもしろいのは、どこが落ちてどこが落ちないかが、直感とずれている点です。公式が公開している内訳を、落ち幅の小さい順に並べると次のようになります(左が圧縮後、右がフル精度)。
- 指示に従う力: 82.66 / 81.25 — 圧縮後のほうが高い
- 数学: 96.57 / 97.06 — 差は0.49
- コーディング: 81.58 / 82.17 — 差は0.59
- エージェント・ツール呼び出し: 77.57 / 79.74 — 差は2.17
- 知識と推論: 83.95 / 86.66 — 差は2.71
- 画像: 78.59 / 81.64 — 差は3.05
「圧縮すると計算が苦手になりそう」と身構えたくなりますが、実際にいちばん落ちているのは画像と、知識・推論です。数学はほとんど変わっていません。つまり、落ちるかどうかは「難しそうかどうか」ではなく「自分がやらせたい作業かどうか」で決まります。だから自分の用途で試して確かめる姿勢は、やはり必要です。
なお同社は、7月に公開した前世代の維持率95%から98%超へ縮まったことをもって、今回を実質的に「ロスレス」と表現しています。裏を返せば、前の世代は5%落ちていたということです。圧縮率の数字だけでなく、どの世代の話かも合わせて見ておくと読み違えません。
量子化・蒸留・プルーニングの違いを整理する
モデルを小さくする方法は、大きく3つに分かれます。名前が似ていて混ざりやすいので、ここで区別しておきましょう。
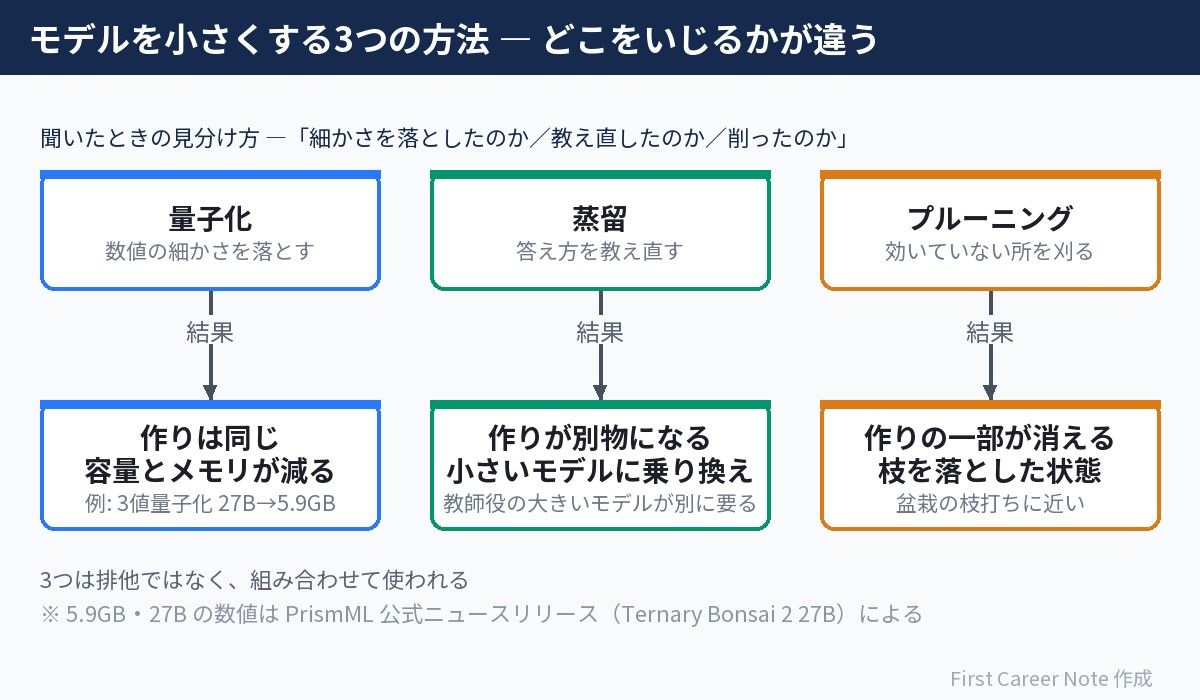
- 量子化: 数値の細かさを落とす。中身の作りは変えず、容量と必要メモリが減る
- 蒸留(じょうりゅう): 大きいモデルの答え方を、小さいモデルに教え直す。作りそのものが別物になり、教師役の大きいモデルが別に必要になる
- プルーニング: ほとんど効いていない部分を刈り取る。盆栽の枝を落とす作業に近い
3つは排他ではなく、組み合わせて使われます。用語を聞いたときは「細かさを落としたのか、作り直したのか、削ったのか」で置き場所を決めると、頭の中が散らかりません。
小さいモデルは運用・監視の現場でどう効くのか
運用や監視の担当者にとって、小さいモデルの価値は「賢さ」より「持ち込みやすさ」にあります。外に出せないログを、社内の機械の中だけで処理できるからです。
たとえば、深夜に飛んできたアラートの本文を3行に要約する、障害連絡の文面から機器名と時刻だけを抜き出す。こうした仕事は最高の賢さを必要としません。手元で動く小さなモデルで十分に足ります。
方向性が違う例として、Cactus Computeの「Needle 3」も見ておく価値があります。こちらは大きいモデルを圧縮したのではなく、はじめから小さく作られた専用モデルです。8〜29MBという1つのバイナリで、ツール呼び出し・項目の抜き出し・文章のベクトル化に用途をしぼり、Raspberry Pi 5で毎秒400〜4,000トークンの生成速度が出ると公開されています。用途を捨てるほど小さく速くできる、という分かりやすい実例です。
クラウドのGPUを借りる稟議は、1〜3年目には重い作業です。手元で動く選択肢を1つ持っておくと、試すまでの距離がぐっと縮まります。
筆者の考察|量子化モデルを試す前に見る3つの数字
紹介記事を読んで終わりにしないために、私はいつも次の3つを先に確認しています。見る順番も、この通りがおすすめです。
- 必要メモリ: 5.9GBはモデル本体の話。実際は入力の長さぶんの余裕が別に要る
- 毎秒のトークン数: 自分の機械での実測値。紹介記事の数字は最上位のGPUのことが多い
- ベンチマークの内訳: 総合スコアで喜ばない。自分がやらせたい作業の欄がどう動いたかを見る
3つ目は、さきほどの内訳がそのまま理由です。総合98.2%という1つの数字は、画像で3.05落ちたことも、指示に従う力が上がったことも隠してしまいます。スクリーンショットを読ませたいなら画像の欄を、手順どおりに動かしたいなら指示追従の欄を見る。それだけで判断の精度が変わります。
1つ目も見落としがちです。メモリの空きがモデルの大きさぎりぎりだと、動いても遅くて実用になりません。メモリの価格が上がっている今、手元の空き容量は先に測っておく価値があります。
まず小さいモデルで手順を通し、そのあと大きいものへ進むのが安全です。
まとめ|3値量子化から押さえたい3点
- 3値量子化は、重みを-1・0・+1で表して容量を減らす手法。27Bのモデルが5.9GBに収まった例が出てきた
- 総合スコアは元の98.2%。ただし落ち方は一様ではなく、画像と知識・推論で大きく、数学ではほぼ落ちない
- 小さくする方法は量子化・蒸留・プルーニングの3つ。細かさを落とす、教え直す、削る、で区別する
次の一歩は、手元のパソコンの空きメモリを確認することです。数字が分かれば、どのモデルなら載るかが自分で判断できるようになります。
あわせて読みたい
最新モデルのベンチマークと料金の見方は、次の記事で整理しています。
参考リンク
- Introducing Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint(PrismML 公式ニュースリリース)(一次情報。1.76ビット・5.9GB・262Kトークン・能力別スコアの内訳・速度・前世代からの改善)
- Bonsai 2(Hugging Face・PrismML公式コレクション)(一次情報。公開されている重みとライセンスの確認先)
- Qwen3.8-27Bを9分の1に圧縮も性能98.2%維持の「Bonsai 2 27B」(PC Watch)(インプレスのニュース記事。日本語での経緯のまとめと電力効率の数値)
- Needle 3(Cactus Compute 公式)(一次情報。8〜29MBという大きさ、用途、Raspberry Pi 5での速度)

コメント
コメント一覧 (2件)
[…] 載せられるモデルの側も変わってきています。同じ賢さのまま必要メモリを9分の1にする圧縮については、3値量子化のしくみを整理した記事をどうぞ。 […]
[…] 「版が違う」「条件の注記がある」「出している側が選んだ指標」という3つの落とし穴は、監視ダッシュボードの数値を読むときとまったく同じです。集計期間や閾値の違う2つのグラフを並べて「増えた」と言ってしまう事故は、現場でも起きます。AIモデルの比較表で練習しておくと、日常の数値確認にもそのまま効きます。小さなモデルでどこまで代替できるかは27Bのモデルが5.9GBに収まる|3値量子化という圧縮のしくみも参考になります。 […]