深夜にアラートが鳴るたび、「これは本当に人を起こす案件なのか」と迷っていませんか。AIに聞いてみようと思っても、長い文章が返ってきて、結局そのまま読む時間がない。そんな経験はよくあります。
この記事では、2026年9月15日にTypeSafe AIが早期アクセスで公開した「Jev」という新しいモデルを取り上げます。読み終えると、なぜ「文章を書かないAI」という発想が出てきたのか、それが運用・監視の仕事にどう効くのかがわかります。
結論を先に言います。Jevは答えを文章で書かず、「どれを選ぶか」「何点か」「その記述は本当か」だけを確率つきで返します。つまり、判断はAIに任せ、そのあとの分岐は自分のコードで書く、という役割分担のための道具です。
Jevとは?文章を書かずに判定だけを返すAI
Jevは、テキストや業務データを読んで、分類・採点・条件判定の結果を確率つきで返すモデルです。開発元はTypeSafe AIで、2026年9月15日に早期アクセスの提供が発表されました。ウェイトリストに登録した開発者から順に案内される段階なので、今日から誰でも試せるわけではありません。
同社を率いるDiogo Almeida氏は、OpenAIでChatGPTの基礎となる研究に携わった人物です。約2年の非公開開発を経ての発表で、Jevは同社が「System One Models」と呼ぶモデル群の最初の公開モデルにあたります。
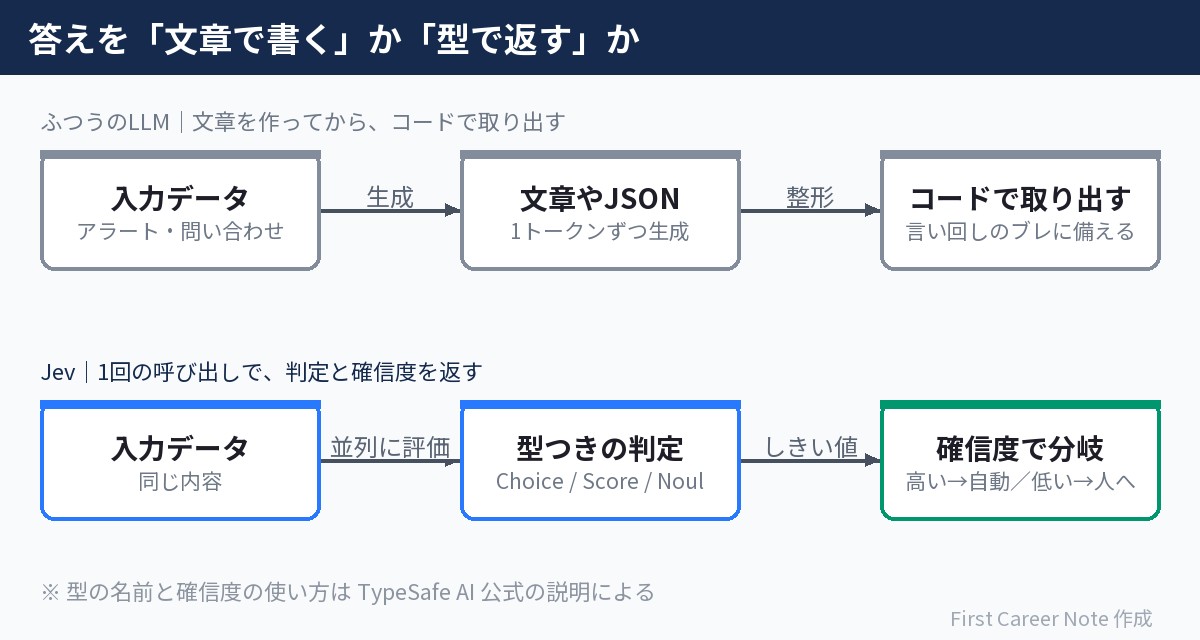
ふつうのLLM(大量の文章で学習した言語モデル)は、聞かれたことに文章で答えます。便利ですが、プログラムから使うときは少し困ります。返ってきた文章から必要な部分を取り出し、想定外の言い回しに備えて後始末のコードを書くことになるからです。
たとえば、窓口の人に「この問い合わせ、返金対象ですか」と聞いたとします。三分ぐらいかけて丁寧に事情を説明されるより、「対象です。確からしさは9割」と一言で返ってくるほうが、次の手続きに進めます。Jevが目指しているのは後者の答え方です。
要するにJevは、賢さを増やす方向ではなく、答えの形をプログラムに合わせる方向に振ったモデルだといえます。
Jevが答える3つの形と、確率が付いてくる意味
Jevへの質問は三つの形式に整理されています。公式ドキュメントでの呼び名と、運用の現場で使う場面を並べると次のようになります。
- Choice(選択肢から1つを選ぶ): この事象はネットワーク・ディスク・アプリのどれに近いか
- Score(評価尺度に沿って採点する): この障害の緊急度は何点か
- Noul(記述が真である確率を0〜1で返す): 「このアラートは即時対応が必要だ」は本当か
ChoiceとScoreでは、判断結果に加えて確率分布と確信度も返ってきます。ここが地味に効きます。確信度にしきい値を設け、そのまま自動処理を続けるか人の確認に回すかを決める使い方は、公式サイト自身が示しているものです。
AIの判断をそのまま信じるのではなく、自信のないときだけ人が出ていく。この設計は、以前に書いた深夜アラートの一次調査をAIに任せる話とも相性がよい考え方です。
なお、この確信度を実際の正答率に対応させるために、同社は「Reinforcement Learning for Calibrated Decisions(RLCD)」と呼ぶ強化学習の手法を使ったと説明しています。確率が当てずっぽうの数字にならないよう、訓練の段階で合わせ込んでいるということです。
つまり確率は、AIと人間の間に引く線をどこに置くかを、自分で決めるための材料になります。
なぜJevは速いのか|一語ずつ書かない仕組み
Jevが速い理由は、文章を一語ずつ作る作業をやめたからです。
ふつうのLLMは、次に来る言葉を一つ決め、それを踏まえてまた次を決める、というやり方で文を作ります。「true」という四文字を返すためにも、この往復が何度か起きます。Jevは答えの候補があらかじめ決まっている前提に立ち、出力を並列に計算します。
くじ引きにたとえると、箱から紙を一枚ずつ引いて文字をつなげるのではなく、箱の中身を上から一度だけ見て「当たりが多いほうはこっち」と答えるようなものです。
複数の質問を1回のAPI呼び出しにまとめられる点も効いてきます。同じデータをもとに、それぞれの質問が独立して並列に評価される作りです。読み込んだ前提を毎回作り直さずに済ませるという方向は、LLMの料金が下がらない理由を書いた記事で触れたキャッシュの考え方と同じところを向いています。
数字は出どころを分けて見る必要があります。公式ブログに書かれているのは「System One型の質問で、同じ知能水準の既存LLMと比べて40〜200倍速い」「応答時間は端から端まで70〜500ミリ秒」「入力100万トークンあたり0.042ドル、出力は無料」の3点です。一方、「コストが40分の1から400分の1」は公式ブログには書かれておらず、同社のXでの投稿として技術評論社が紹介している値です(そちらでは速度も20〜200倍と説明されています)。同社が公開しているワークフロー評価の193.6倍速・444.6倍安については、公式自身が「実際に得られる効果の中でも大きい部類」と但し書きを付けています。
第三者の検証も出ていますが、読み方に注意が必要です。エンジニアのnwn氏は、Jevと同じ「候補どうしの確からしさだけを比べる」やり方をGemma3 270Mという小さなLLMで再現し、同じモデルに素直にJSONを生成させた場合と比べて約77倍速くなったと報告しています。これはJevが既存のLLMより77倍速いという話ではありません。速さの正体がモデルの特別さではなく答えの形のほうにある、と示した検証です。
Jev本体の実測もあります。mizchi氏はJev同士に五目並べを打たせ、1手あたり平均500ミリ秒ほど、25手で13,913ミリ秒だったと書いています。公式の公称値は70〜500ミリ秒なので、実測はその上限あたりに位置します。本人はサーバーが米国西海岸にあるため110〜130ミリ秒のネットワーク遅延が乗っているのではないかと推測しています。
運用・監視の現場でJevが効く場面と効かない場面
ここからは筆者の見立てです。Jevが効くのは、判断の種類が前もって決まっていて、同じ判断を大量に繰り返す仕事だと考えています。
運用・監視でいえば、アラートの一次仕分け、ログ行の分類、問い合わせの振り分けが当てはまります。どれも「毎回ちがう答え」が欲しいのではなく、「決まった箱のどれに入るか」を高速に知りたい作業だからです。当番の夜に何百件と流れてくるものほど、一件あたりの速さと料金が効いてきます。
逆に効かないのは、答えの選択肢を自分で思いつく必要がある仕事です。原因の見当がまったく付かない障害を調べる、手順書を書き直す、といった作業では、道具を自分で選んで動くAIエージェントのほうが向いています。
選択肢を用意できるならJev、用意できないならエージェント。この線引きを持っておくと、使い分けで迷いにくくなります。
Jevを過信しないために知っておきたいこと
いま飛びつくべきかというと、そこは慎重でよいと考えています。理由は三つあります。
一つ目は、提供がまだ早期アクセスの段階だということです。ウェイトリストから順に案内される状態なので、来月の運用計画に組み込むには時期が早いです。
二つ目は、「ハルシネーションがない」という説明の範囲が限定的なことです。保証されているのは、指定した選択肢にない答えや、決めたデータ構造に合わない出力が出ないことです。選択肢の中から誤ったものを選ぶ、つまり判断そのものを間違える可能性は残ると同社も認めています。型が合っていることと、答えが正しいことは別の話です。
三つ目は、速さの差が縮まりつつあることです。前出のnwn氏は、比較に使えたLLMがAPIから確率値を取り出せる旧世代の非推論モデル中心だった点を挙げ、今回の結果だけでJevが最新のLLMより優れているとは言い切れないと書いています。さらに、最新の高速な非推論モデルは最初の応答までが100ミリ秒前後の領域に入りつつある、とも指摘しています。
つまりJevの本当の価値は、速さそのものよりも「確率つきの構造化された答えが返ってくる」という窓口の形にあります。その形が便利であるほど、他のモデルも同じ形を用意してくる可能性が高いです。
今やるべきは乗り換えではなく、自分の担当業務のうち「選択肢が決まっている判断」を一つ書き出してみることです。それさえ見つかれば、道具がJevでも別の何かでも、設計は使い回せます。
まとめ|Jevから持ち帰る3つのこと
- Jevは文章を書かず、Choice・Score・Noulという3つの形で判定を確率つきに返すモデル。判断はAI、分岐は自分のコードという役割分担のための道具です
- 速さの正体はモデルの特別さではなく答えの形にあります。だからこそ他のモデルが同じ窓口を用意すれば差は縮まります
- 型が合うことと答えが正しいことは別です。確信度にしきい値を引いて、自信のないときだけ人に回す設計まで含めて考えます
次の当番の夜に、対応したアラートを5件だけ振り返ってみてください。そのうち何件が「決まった箱に入れるだけ」の判断だったかを数えると、AIに任せられる範囲が見えてきます。
参考リンク
- Introducing System One Models & Jev – TypeSafe AI 公式ブログ(一次情報。速度・コストの公称値、価格、早期アクセスの位置づけ)
- TypeSafe AI 公式サイト(確信度にしきい値を設ける使い方、ワークフロー評価の数値)
- TypeSafe AI、AIモデル「Jev」の早期提供を開始 – gihyo.jp(技術評論社のニュース記事。Choice/Score/Noulの定義、料金、「ハルシネーションなし」の但し書き)
- TypeSafeのJevを正しく驚く、それってLLMでできませんか? – Zenn(個人の検証記事。Gemma3 270Mでの再現と77倍、比較条件の限界)
- jev 同士に五目並べで対戦させた – Zenn(個人の実測記事。1手あたりのレイテンシ)
- Jevとは何か? 従来型LLMやAIエージェントとの違いを理解する – Qiita(TISI株式会社の横井公紀氏による個人の解説記事)

コメント
コメント一覧 (2件)
[…] 判定そのものをAIに任せる道具も出てきています。文章を書かずに確率つきの判定だけを返すモデルについては、文章を書かないAI「Jev」の記事で整理しました。 […]
[…] この「次の単語を当てる」仕組みをあえて使わず、判定だけを返すモデルも登場しています。文章を書かないAI「Jev」の記事で取り上げました。 […]