「Opus 5.5が出たけれど、上位のFable 5.1とどっちが上なの?」「ベンチマークの数字をどう読めばいい?」と感じていませんか。2026年9月22日(米国時間)にAnthropicが公開した新モデル「Claude Opus 5.5」は、3週間前に出たばかりの最上位モデル「Claude Fable 5.1」と、公式の比較表で並べられています。
この記事では、Anthropicの発表ページに載っている数字だけを使って、次の3点を整理します。
- Opus 5.5とFable 5.1、Opus 5のベンチマーク9項目の比較表
- 「Fable 5.1並みの性能で4割安い」という言葉の中身(単価とトークン数)
- ベンチマークの数字を読むときに、新人が引っかかりやすい3つの落とし穴
先に結論を言うと、Anthropic自身が公開した9項目の表では、Opus 5.5はすべての項目でFable 5.1を上回っています。それでもFable 5.1のほうが料金は2.5倍高いままです。この「逆転」をどう受け取るかが、この記事の本題です。(数値は2026年9月23日に発表ページを確認したものです)
結論:公式の比較表ではOpus 5.5が9項目すべてでFable 5.1を上回る
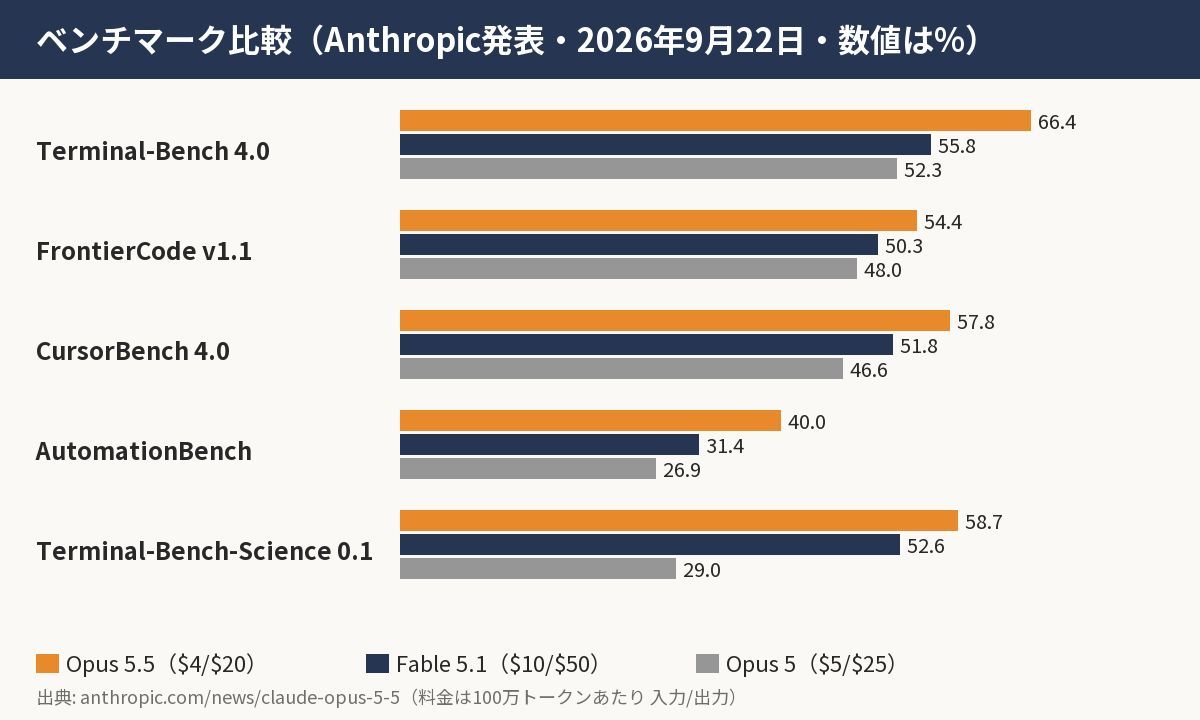
まず、Anthropicが発表ページに掲載した表をそのまま転記します。比較対象には旧世代のOpus 5と、OpenAIの2モデルも含まれています。
| ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1(Main) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| GDPval-AA v2.1(Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam(ツール使用) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0(partial) | 81.8% | 80.7% | 74.0% | — | — |
| Chartography(ツール使用) | 89.0% | 88.4% | 83.4% | — | — |
出典はAnthropicの発表ページです。太字はその行で最も高い値を示しています。
読み取れることは3つあります。
- Opus 5.5は9項目すべてでFable 5.1より高い。差が大きいのはTerminal-Bench 4.0(10.6ポイント)とAutomationBench(8.6ポイント)で、どちらもエージェント的に手を動かす作業の指標です。
- 他社を含めるとOpus 5.5が1位でない項目が2つある。AutomationBenchとTerminal-Bench-ScienceはGPT-6 Astraが上です。
- Opus 5からの伸び幅が最も大きいのはTerminal-Bench-Science(29.0%→58.7%)で、科学系のワークフローが約2倍になっています。
Anthropicはこの表をもとに「エージェント的なコーディング、コンピュータ操作、ナレッジワークで首位」と説明しています。ここで大事なのは、これがAnthropic自身が選んだ指標での自社発表だという点です。後の章で読み方を整理します。
料金は「Fable 5.1の5分の2、Opus 5より4割安い」
ベンチマークで上回っているのに、料金はFable 5.1のほうが高い。この関係を表にすると次のようになります(100万トークンあたり、米ドル)。
| 項目 | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| 入力 | $4 | $5 | $10 |
| 出力 | $20 | $25 | $50 |
| キャッシュ読み取り | $0.20 | $0.50 | $0.25 |
| キャッシュ書き込み | $5 | $6.25 | —(発表ページに記載なし) |
Opus 5.5の単価はOpus 5から入力・出力とも20%引き下げられました。それなのにAnthropicは「一般的なワークロードでは40%安くなる」と書いています。20%と40%の差は、同じ仕事を終えるまでに使うトークン数が減ることから来ています。発表ページの説明は「デフォルト設定で、一般的なワークロードでOpus 5より40%コストが下がる」というもので、単価の値下げとトークン効率の両方を含んだ数字です。
もう1つ見逃せないのがキャッシュ読み取りの60%減($0.50→$0.20)です。コーディング支援やエージェント用途では、同じシステムプロンプトやツール定義を何十回も読み直すため、費用の大半がキャッシュ読み取りになります。この項目が安くなるほど、長く動かすエージェントの費用が下がります。キャッシュがどういう条件で壊れるかは、LLMの料金が下がらない理由|キャッシュが壊れる3つの操作で整理しています。
Fable 5.1は入力$10・出力$50で、Opus 5.5の2.5倍です。Anthropicは「Fable級の仕事を、より安く回せる」という位置づけでOpus 5.5を出しています。
ベンチマークを読むときの落とし穴3つ
数字はそのまま信じずに、3つの点を確認してから比べるのが安全です。今回の2つの発表ページを並べると、その必要性がよく分かります。
1. 同じ名前のベンチマークでもバージョンが違う
Opus 5.5の発表表では「GDPval-AA v2.1」でFable 5.1が1735ですが、3週間前のFable 5.1の発表ページでは「GDPval-AA v2」で1853と書かれています。同じモデルなのに100以上違うのは、性能が落ちたのではなく測る問題セットの版が変わったからです。CursorBenchも3.2.0(Fable 5.1の発表時は73.4%)から4.0(今回は51.8%)へ変わっています。
つまり、別のページの数字を持ってきて横に並べてはいけません。比べるなら、同じ表に同じ版で載っている値どうしだけです。この記事の表を1枚の発表ページからだけ転記しているのはそのためです。
2. 「partial」「with tools」の注記は条件そのもの
OSWorld 2.0の「partial」は部分点を含む採点方式、Humanity’s Last ExamやChartographyの「with tools」はWeb検索などのツールを使った状態の値です。ツールなしの値はFable 5.1の発表ページに別途あり、Humanity’s Last Examはツールなし60.9%・ツールあり65.0%と約4ポイント違います(なお今回の表ではツールありが65.6%で、ページが違うと同じ条件でも値がずれる点は1つ目の落とし穴と同じです)。注記を落として引用すると、条件の違う数字を同じ土俵に乗せてしまいます。
3. 自社発表の表は「自社が選んだ指標」
今回の9項目はAnthropicが選んだものです。他社が強い指標が入っていない可能性は常にあります。実際、表の中でもAutomationBenchとTerminal-Bench-ScienceはGPT-6 Astraが上でした。発表ページの数字は「その会社が見せたい面」だと理解したうえで、自分の用途に近い指標だけを見るのが現実的です。
Fable 5.1は何のために残るのか
ベンチマークで負けているなら、Fable 5.1を選ぶ理由はないのでしょうか。発表ページから読み取れる範囲では、Fable 5.1の位置づけは次のとおりです。
- Fable 5.1の発表ページでは「コーディング、ナレッジワーク、長時間の問題解決」に強いモデルとして紹介されています(Opus 5.5の発表では、Opus 5.5を新たな首位モデルとしています)。今回の表にない長時間の自律作業が主戦場です。
- Fable 5.1とMythos 5.1は同じモデルで、安全策(セーフガード)の水準だけが違います。Mythos 5.1は、サイバー防御や生命科学の分野で審査を通った組織向けのプログラムを通じてのみ提供されます。
- Fable 5.1もキャッシュ読み取りが$0.25で、前のFable 5より75%下がっています。Anthropicは「一般的なワークロードで約25%、高度なエージェント作業で最大45%の削減」と説明しています。
つまり、ベンチマークの平均点で選ぶならOpus 5.5、数分から数十分かけて自律的に進める作業を任せるならFable 5.1、という切り分けが発表内容から見える線です。ただし後者の優位は今回の9項目の表には出ていないので、「表で負けているのに高い」という状態を受け入れて使うことになります。
使い分けの目安|迷ったらOpus 5.5、Fable 5.1を残す3つの場面(筆者の考え)
ここからは発表資料を読んだうえでの筆者の考えです。数字で裏づけられている部分と、推測の部分を分けて書きます。
基本線は「まずOpus 5.5」
公開された9項目の表でOpus 5.5が全項目で上回り、料金は5分の2です。表に載る種類の仕事、つまりコードの修正、ターミナル操作、資料作成、調べ物でFable 5.1を選ぶ根拠は、表からは出てきません。Anthropicが「Fable級の性能をより安く」という位置づけで出している以上、大半の用途をOpus 5.5に寄せたい意図があると考えるのが自然でしょう(ここは推測です)。
Fable 5.1を残す3つの場面
- 長時間の自律作業。数十分から数時間、途中で人が見ずに進める案件です。発表ページがFable 5.1の主戦場としているのはここで、9項目の表はこの領域を測っていません。
- 判断の精度が費用より重い仕事。本番設定の変更、契約や規約の読み込み、事実確認が命の文章など、やり直しのコストが大きい作業では、単価差より「1回で当たる確率」を優先してよいと思います。ただし、Fable 5.1のほうが当たる確率が高いことは今回の表では示されていません。これも推測です。
- Fable 5.1で調整済みのプロンプトや評価がある場合。乗り換えには「切り替えて数える」作業が必要で、それ自体がコストです。動いている仕組みを急いで変える理由は、表の数字だけではありません。
注意点が2つ
- 表の差は自社発表の指標での話です。実務での体感差はもっと小さいことも、用途によっては大きいこともあります。
- 安全策の強さは使い分けの理由になりにくい点です。発表によると、Opus 5.5はサイバーセキュリティや生物分野などでFable 5.1と同種の安全策をかけて提供される初めてのOpusです。「Fable 5.1は断られやすいからOpus 5.5へ」という期待で乗り換えると、当てが外れる可能性があります。
切り替えるなら、いきなり全部ではなく、定型の処理を1本だけ1週間Opus 5.5で回して、出力の手直し回数とトークン数を比べるのが安全です。次の章で書く「数える」作業の最小単位がこれです。
運用・インフラの現場ではこう効く
運用・監視の1〜3年目にとって、この発表が関係するのは主に3つの場面です。
モデル切り替えは「試して数える」作業になる
Opus 5からOpus 5.5へは、APIのモデルID(claude-opus-5-5)を差し替えるだけで済みます。ただし「40%安い」は一般的なワークロードでの平均値です。自分たちの用途で本当に安くなるかは、切り替え前後で1回の作業あたりの入力・出力・キャッシュ読み取りトークン数を記録して比べるしかありません。請求書の合計だけ見ると、利用回数の増減と混ざって判断できなくなります。
キャッシュ前提の設計が効く
キャッシュ読み取りが$0.20になったことで、システムプロンプトやツール定義を固定して使い回す設計の効果が大きくなりました。逆に、プロンプトの先頭に日時やリクエストIDを入れる作りだとキャッシュが毎回壊れ、値下げの恩恵を受けられません。運用手順書やアラート対応のテンプレートをAIに渡す仕組みを作るなら、AIエージェントの暴走を止める4層|課金爆発と鍵の流出を防ぐで書いた課金上限の設計とセットで考えてください。
ベンチマークの読み方は、監視の数値の読み方と同じ
「版が違う」「条件の注記がある」「出している側が選んだ指標」という3つの落とし穴は、監視ダッシュボードの数値を読むときとまったく同じです。集計期間や閾値の違う2つのグラフを並べて「増えた」と言ってしまう事故は、現場でも起きます。AIモデルの比較表で練習しておくと、日常の数値確認にもそのまま効きます。小さなモデルでどこまで代替できるかは27Bのモデルが5.9GBに収まる|3値量子化という圧縮のしくみも参考になります。
まとめ
- Anthropicの発表表では、Opus 5.5が9項目すべてでFable 5.1を上回った。他社を含めるとAutomationBenchとTerminal-Bench-ScienceはGPT-6 Astraが上
- 料金はOpus 5.5が入力$4・出力$20でFable 5.1の5分の2。Opus 5比の「40%減」は単価20%減とトークン効率の合計で、キャッシュ読み取りは60%減
- ベンチマークは同じ表・同じ版・同じ条件の値だけを比べる。別ページの数字を並べると、同じモデルでも100以上ずれる
- 使い分けはまずOpus 5.5。Fable 5.1を残すのは長時間の自律作業・やり直しの重い判断・調整済みの仕組みがある場合。切り替えは定型処理1本から「数えて」決める
次に取る行動は1つです。いま使っているモデルで「1作業あたりのトークン数」を記録しておくこと。それがないと、次のモデルが本当に安いかを判断できません。
あわせて読みたい
GPT-6 Astraを載せた常時稼働エージェントの権限と料金は、次の記事で整理しています。
参考リンク
- Introducing Claude Opus 5.5 – Anthropic(2026年9月22日。ベンチマーク表・料金・提供先の出典)
- Introducing Claude Fable 5.1 and Claude Mythos 5.1 – Anthropic(Fable 5.1の発表表・料金・Mythosとの違いの出典)
- Anthropic、「Claude Opus 5.5」公開 Fable 5.1並みの性能で利用コスト4割減 – ITmedia NEWS(国内報道)
- Anthropic Launches Claude Fable 5.1 With Lower Costs and Fewer False Positives – MacRumors(Fable 5.1の発表日の確認に使用)

コメント