「もう一回まわしたら通りました」。テストが落ちたときに、こう言われて終わった場面を見たことはありませんか。コードは何も変えていないのに、結果だけが変わる。気持ち悪いけれど、原因の調べ方が分からずそのままにしている人も多いはずです。
この記事では、この現象の名前である「Flaky Test」の正体と、起きる4つの原因を整理します。あわせて、AIで開発量が増えた現場でなぜこれが深刻になったのか、そして監視の仕事にも効く見方までまとめます。
結論を先に言います。再実行で通るテストは「たまたま直った」のではなく、待ち方・後片づけ・環境・時刻のどれかが曖昧なままだという合図です。犯人はほぼこの4つに収まります。
Flaky Testとは?落ちたり通ったりするテストの正体
Flaky Test(フレーキーテスト)とは、同じコードと同じ手順なのに、実行するたびに結果が変わるテストのことです。flakyは「もろい、当てにならない」という意味の英語です。
やっかいなのは、失敗しても本当のバグとは限らない点です。だから現場では再実行が習慣になり、やがて「赤は無視していい」という空気が生まれます。そうなると、本物の不具合も見逃されます。
身近な例でたとえます。朝のアラームが、鳴る日と鳴らない日があるとします。本当に困るのは寝坊そのものではなく、「アラームを信用しなくなること」です。信号が信用を失うと、仕組みとして役に立たなくなります。
つまりFlaky Testの本当の被害は、1回の失敗ではなく、テスト全体への信頼が下がることです。だからこそ「後で直す」ではなく、見つけた時点で原因の型に当てはめる必要があります。
AIコーディングでCIが詰まる理由とLinearの実例
結論から言うと、AIで書く量が増えた結果、テストを動かす側が先に限界を迎えています。
理由は単純です。AIエージェントが作るコードの量は増えても、そのコードを確かめるCI(変更のたびに自動でビルドとテストを流す仕組み)の速さは変わりません。すべての変更がここを通るので、ここが行列の発生地点になります。
具体例として、プロジェクト管理ツールを開発するLinearが、2026年9月に自社CIの作り直しを公開しました。同社のテストは年初から4倍近くに増えたにもかかわらず、プルリクエストの確認待ちの時間を6分超から5分強へ縮めています。効果が大きかったのは、数秒で終わる7つのチェックがそれぞれ別の実行環境を立ち上げていたのを、2つのジョブにまとめた変更です。準備の重複が7回から2回に減り、6月の利用実績で試算すると、ランナーの使用時間を月あたり約8万7000分、CI全体の11.8パーセント削れたとしています。
注目したいのは、この対策のほとんどが「無駄な待ち」を消す作業だという点です。変更内容を判定するジョブでリポジトリの取得範囲を絞り、いちばん遅いものを94秒から20秒にする。APIのテストで必要なパッケージだけを入れ、インストールを44〜73秒から16〜18秒にする、といった積み上げです。
Linearの記事自体はFlaky Testには触れていませんが、ここでFlaky Testが重くのしかかります。不安定なテストが1本あると、再実行で待ち時間が丸ごと倍になるからです。速さの改善とFlaky Testの退治は、同じ問題の裏表だと考えてよいでしょう。
Flaky Testが起きる4つの原因
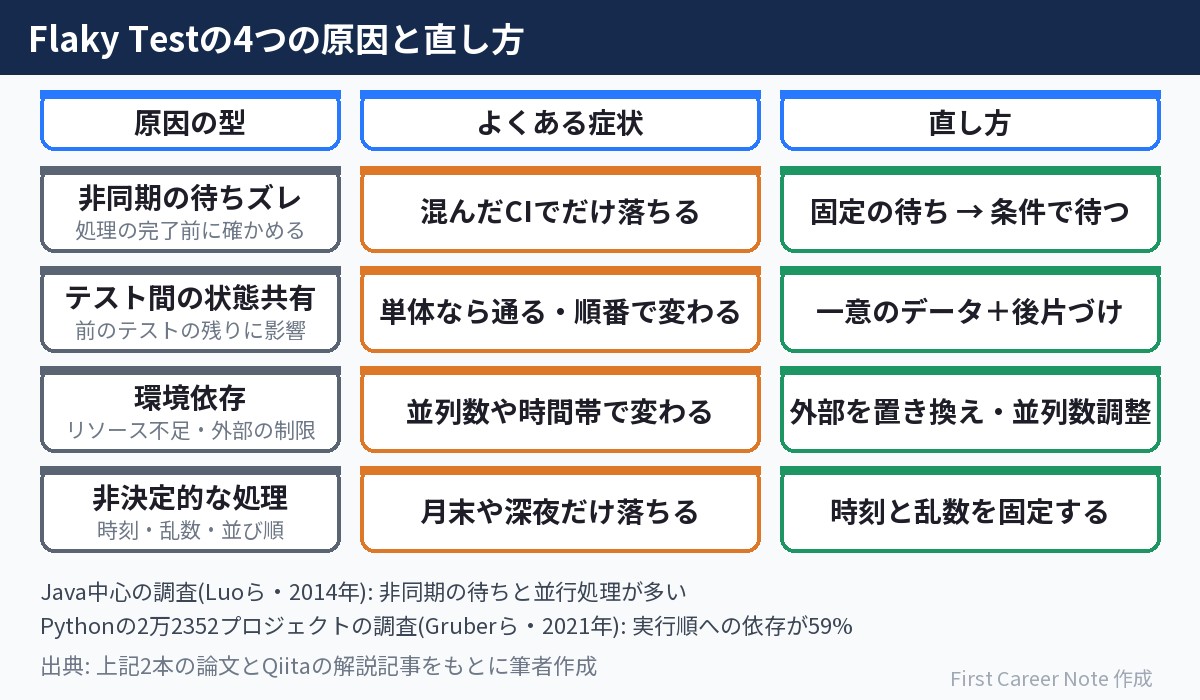
原因は大きく4つに分類できます。落ちたテストを見たら、まずこの4つを疑ってください。
- 非同期処理の待ちズレ: 通信や画面の描画が終わる前に、結果を確かめてしまう
- テスト間の状態共有: 前のテストが残したデータや設定値に、後のテストが影響される
- 環境依存: CI側のメモリやCPUが足りない、外部サービスの呼び出し制限に当たる
- 非決定的な処理: 現在時刻、乱数、並び順が決まっていない一覧などを前提にしている
どの型が多いかは、言語や作り方で変わります。Javaのオープンソースを調べたLuoらの研究(2014年)では、非同期の待ちと並行処理が多い原因として報告されました。一方、Pythonの2万2352プロジェクトを調べたGruberらの研究(2021年)では、実行順への依存、つまり2つ目の状態共有が59パーセントを占め、テスト基盤の問題が28パーセントで続いています。
1つ目の待ちズレでは、とくに「3秒待つ」のような固定の待ち時間が危険です。開発機では間に合っても、混み合ったCIでは2.9秒で終わらないことがあります。そこで固定待ちをやめ、「この文字が表示されたら次へ進む」という条件の待ち方に変えます。
2つ目は後片づけの問題です。テストごとに時刻を混ぜた一意のIDでデータを作り、終わったら消す。これで隣のテストと取り合いになりません。
4つ目は、時刻を固定する仕組みを使えば防げます。月末だけ落ちるテストや、日付が変わる深夜だけ落ちるテストは、ほぼこの型です。
4つに分けて考える利点は、勘に頼らずに調べる順番が決まることです。再実行の前に、どの型かを言い当てる癖をつけましょう。
逆に、再実行で1回通ったからといって、そのテストが安定しているとは言えません。Gruberらの研究では、通ったテストがFlakyではないと95パーセントの確からしさで言うには、平均170回の再実行が必要だと試算しています。再実行はFlaky Testを見つける手段としては効率が悪いのです。
Flaky Testを疑うときの点検リスト6項目
Qiitaの解説記事のチェックリストを、上から順に見ていける形に筆者が並べ替えました。
- 固定の待ち時間が書かれていないか → 条件を見て待つ書き方に変える
- テストデータが他と重なっていないか → 一意のキーを作る、または元に戻す
- 単体で流しても通るか → 実行順に依存していないかを確かめる
- 時刻や日付を前提にしていないか → 時刻を固定する仕組みを使う
- 外部のサービスを直接呼んでいないか → 代わりの応答を返す仕組みに置き換える
- 並列で流しすぎていないか → 同時実行の数を調整する
この順番にしたのは、上の3つが自分の書いたテストの中だけで直せる範囲だからです。下の3つは環境や設計に手が入るため、先輩に相談する材料になります。
点検の結果は、テストの名前のそばにメモとして残すと効きます。次に同じ現象が出たとき、調べ直す時間がなくなります。
運用・監視の現場でFlaky Testの考え方が効く理由(筆者の考察)
ここからは筆者の考えです。テストを書く機会が少ない運用・監視の担当者でも、この4分類は今日から使えると考えています。
理由は、鳴ったり鳴らなかったりするアラートが、構造としてFlaky Testと同じだからです。監視の閾値を超えたかどうかは、タイミング・前回の状態・サーバーの混み具合・集計の時間帯で揺れます。原因の型が、そのまま重なります。
たとえば、深夜だけ鳴る警報を思い出してください。バックアップと重なって負荷が上がる時間帯なら、それは環境依存です。前の警報が復帰扱いにならず残っていたなら、状態共有の問題です。「とりあえず再確認」で閉じる前に、どの型かを書き添えるだけで、引き継ぎの質が変わります。
AIに一次調査を任せる流れは深夜アラートの一次調査をAIに任せる設計でも取り上げました。AIが書いたテストをそのまま信じる危うさはAI生成テストが全部通る理由にまとめています。
結局のところ、求められているのは「当てにならない信号を放置しない姿勢」です。これはツールの知識より先に身につく習慣で、しかも評価されにくい地味な仕事です。だからこそ、早く身につけた人の価値が残ります。
まとめ
- Flaky Testの被害は1回の失敗ではなく、テスト全体が信用されなくなること
- 原因は非同期の待ちズレ・状態共有・環境依存・非決定の4つにほぼ収まる
- AIで変更が増えた現場ではCIが行列の発生地点になり、再実行の代償が大きくなる
次にテストやアラートが「たまたま」落ちたら、再実行の前に4つの型のどれかをメモしてみてください。
参考リンク
- AI coding has made CI a bottleneck, so we reworked ours to keep up(Linear公式・2026年9月) ― テストが4倍近くに増える中での確認待ち短縮と、ランナー使用時間の削減
- An Empirical Study of Flaky Tests in Python(Gruberら・2021年・論文) ― 2万2352プロジェクトの調査。実行順への依存が59%、95%の確からしさには平均170回の再実行
- An Empirical Analysis of Flaky Tests(Luoら・2014年・論文) ― 51のオープンソースプロジェクト、201件の修正コミットから原因を分類した初期の研究
- Flaky Test(不安定なテスト)の主な原因と実務で使える具体的な改善手順・チェックリスト – Qiita ― 4つの原因の整理と点検リスト

コメント
コメント一覧 (2件)
[…] 鳴ったり鳴らなかったりするアラートの見分け方は、テストの世界のFlaky Testの4つの原因と同じ考え方で整理できます。 […]
[…] CIのテストが遅い・不安定といった問題を追うときは、Flaky Testの4つの原因もあわせて読んでみてください。 […]